Ressources numériques en sciences humaines et sociales OpenEdition Nos plateformes OpenEdition Books OpenEdition Journals Hypothèses Calenda Bibliothèques OpenEdition Freemium Suivez-nous

Conférence de rentrée

Source : Lea Ypi

On reste dans le thème des conférences — la traditionnelle conférence de rentrée de mon école de science politique aura lieu dans deux jours, et cette année, nous accueillons Lea Ypi, de la LSE, sur le thème « How Capitalism Undermines Freedom ».

Il ne vous aura pas échappé que Lea Ypi était invitée au Collège de France cette année, sur la chaire « L’invention de l’Europe par les langues et les cultures ». Sa leçon inaugurale, sur la notion de socialisme moral, son cours, sur le même thème, et enfin le colloque « Socialisme et égalitarisme libéral : un dialogue nécessaire », sont tous accessibles en ligne.

Le lien d’inscription à la conférence devrait être disponible à la date où ce billet sortira.

Conférences 2026

L’an dernier, j’avais publié un compte-rendu en deux parties (partie 1, partie 2) des premières journées du REEF, le Réseau d’Études Électorales Françaises (en France ?), qui a tenu sa deuxième journée d’étude début juillet, en marge du Congrès AFSP de Lyon.

Le Congrès lui-même n’éludait évidemment pas complètement le thème de l’analyse électorale, avec deux sections thématiques et plusieurs communications dédiées à la collecte et à l’analyse de données pertinentes pour étudier les comportements électoraux, ou la période électorale plus généralement.

La capture d’écran ci-dessous, par exemple, vient du projet YOUPOL, qui récolte des données sur les « influenceurs politiques » présents sur YouTube et TikTok. Le projet m’a rappelé certains des projets Twitter de l’Institut des Systèmes Complexes, et aussi ce projet, plus récent (et absolument dingue) de collecte de données WhatsApp en Inde1.

Lors de la journée du REEF, la discussion s’est plutôt concentrée sur des initiatives offline, et en particulier sur les enquêtes/questionnaires « sortie des urnes » (QSU) qui ont essaimé un peu partout en France au moment des dernières élections municipales. C’était prévu, et dans la continuité de projets locaux déjà menés sur des scrutins précédents.

Le tour de table sur les QSU a identifié plusieurs difficultés (d’accès au terrain, avec notamment des refus d’accès dans des communes où cela ne s’était jamais produit), plusieurs enjeux (comme le recrutement des étudiants/stagiaires) et plusieurs questions (dont celles de la « rentabilité » pédagogique et scientifique des QSU locaux) qui devraient donner lieu à une nouvelle journée d’étude dans pas trop longtemps : stay tuned.

J’avais prévu de compléter ces deux conférences par quelques-unes des communications de la conférence MeSSH 2026 (Méthodes pour les sciences sociales et les humanités), qui se tenait peu après à Paris, mais la canicule et le retard pris sur d’autres projets ont eu raison de moi. les organisateurs ont opportunément fait circuler les papiers peu avant la conférence, et j’ai pu parcourir les seize communications qui m’intéressaient avec l’aide d’un ventilateur japonais poussé à puissance maximale.

  1. Oui oui, de données WhatsApp, en allant demander à des villageois indiens en porte-à-porte l’accès à leurs groupes WhatsApp privés, pour étudier notamment la diffusion de rumeurs. Il semble que le projet sera répété à plus petite échelle au Brésil l’an prochain (ou cette année, pour l’élection présidentielle ? je ne me souviens plus). []

Représentation graphique des résultats de régressions

L’école d’été Quantilille, à laquelle j’avais assisté comme étudiant il y a quinze ans (time flies), avait un super programme cette année, comme chaque année d’ailleurs, avec un module « Visualisation des données en sciences sociales » (avec R) et un module « Exploration et applications des IA génératives en sciences sociales » (avec Python).

J’ai contribué au premier module, en me chargeant de la section qui portait sur la visualisation de (résultats de) modèles de régression.

Le code est en ligne, et comme le suggère le graphique ci-dessus, nous avons travaillé quasi-exclusivement avec ggplot2, ce qui ne surprendra personne : le package a fait ses preuves au point d’avoir été porté dans d’autres langages (Python, Julia).

On ne peut pas tout couvrir en six heures, et il a manqué du temps pour regarder le résultat des scripts « bonus ». On a quand même réussi à parler un peu des différentes manières de visualiser l’incertitude autour d’un résultat.

La fin du code s’appuie sur l’excellent package marginaleffects, dont la documentation a récemment été publiée sous la forme d’un livre. L’auteur, Vincent Arel-Bundock, avait déjà publié un autre excellent ouvrage de méthodes quantitatives, et a codé plein de packages utiles dont je me sers extrêmement souvent.

Faites-moi signe si le code ne tourne pas de votre côté. On m’a fait remonter quelques messages d’erreur (temporaires) à l’installation d’un autre excellent package, ggstats, mais le reste n’a pas posé souci.

Un problème d’interpolation spatiale

À défaut d’avoir écrit beaucoup de code cette année, j’en ai réécrit un peu.

Si vous suivez mon autre blog, consacré à R, vous avez déjà vu le résultat sur lequel j’ai passé le plus de temps : une réécriture du package R de Joël, spReapportion, package d’interpolation aréale qui était devenu très difficile à installer suite à la suppression de ses dépendances, en faveur du package sf plus récent.

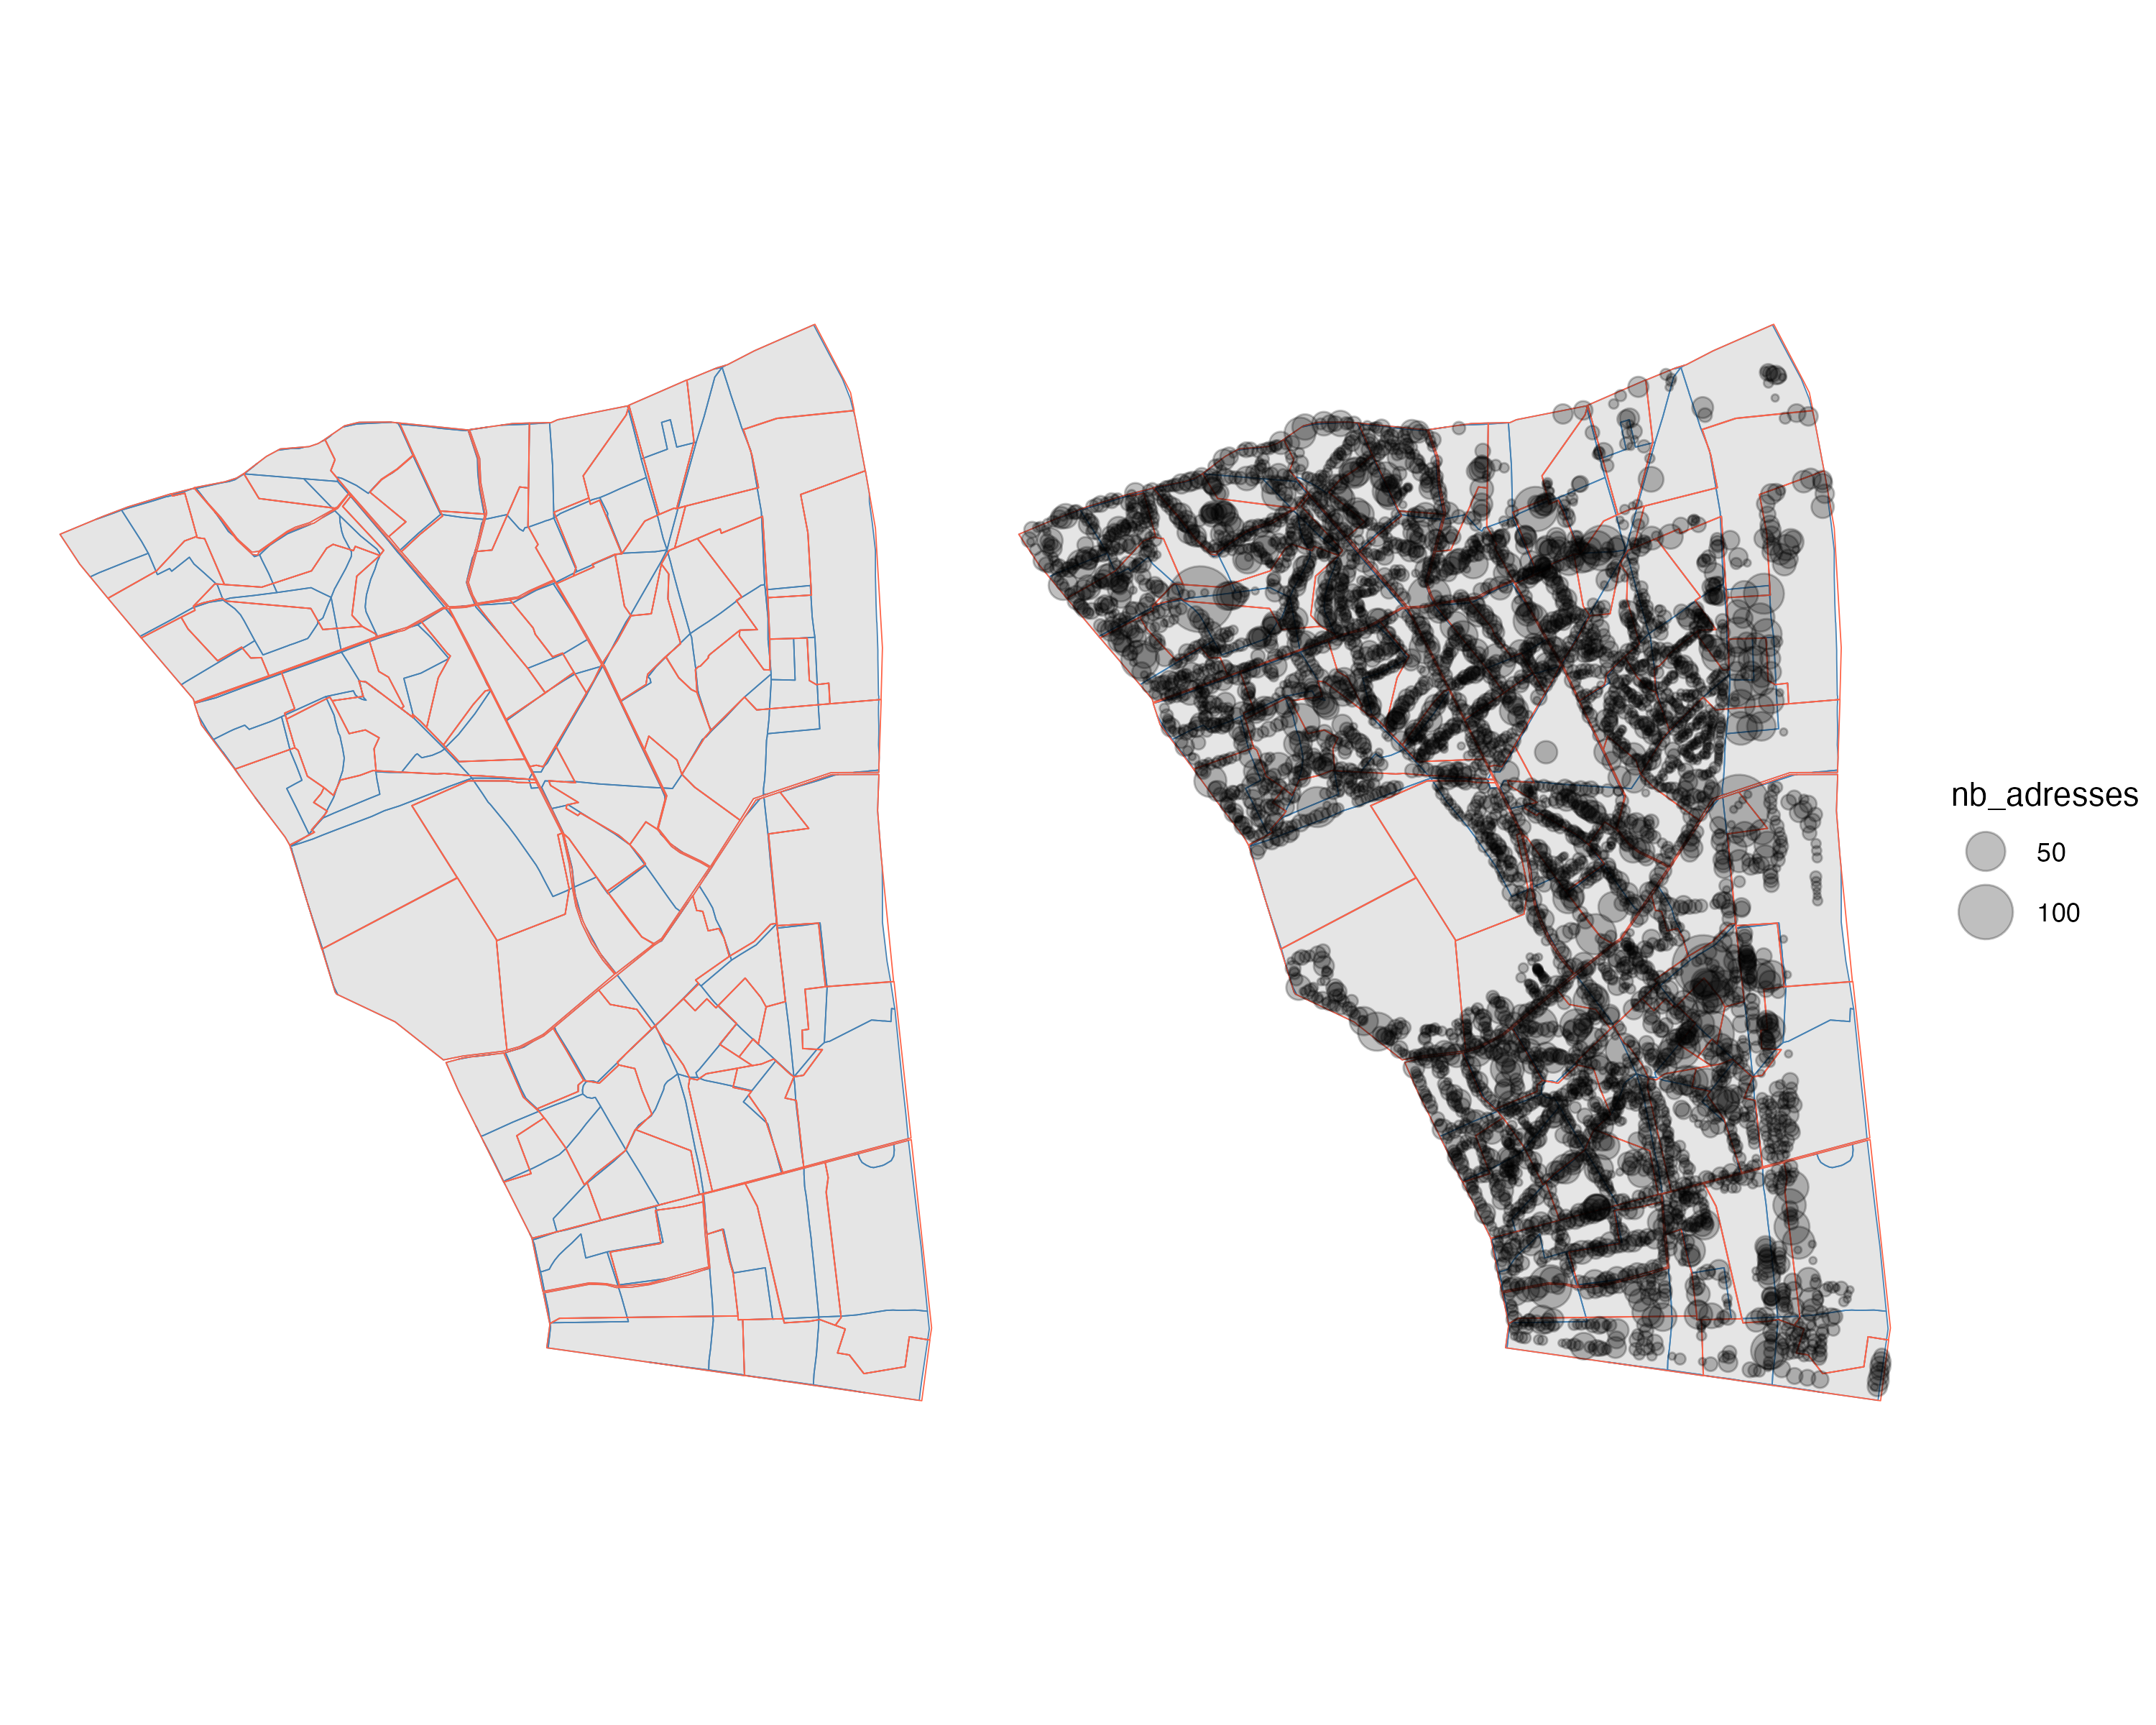
Comme je l’explique dans une note publiée en fin d’année dernière, le package sert à interpoler des données découpées selon un contour géographique – typiquement, les IRIS de l’Insee – avec un autre contour : typiquement, ceux des bureaux de vote, établis par les municipalités. Vous pouvez voir la différence entre les deux maillages géographiques sur la carte de gauche ci-dessous1 :

Il reste un problème à résoudre : comme le montre la carte de droite, les habitants / électeurs ne sont pas uniformément répartis à l’intérieur de chaque IRIS / BV2. En conséquence, quand on interpole les données, on peut vouloir pondérer le résultat de l’interpolation par cette répartition spatiale très inégale.

Joël avait écrit le code nécessaire pour effectuer cette pondération, mais sans fournir d’exemple. Après quelques bricolages, j’ai abouti à l’exemple fourni plus haut, puis réécrit son code, puis publié le tout, mais sans avoir pu vérifier que son package et ma version réécrite donnaient bien les mêmes résultats. C’est désormais chose faite depuis deux semaines, grâce à un collègue (merci Tristan) disposant encore d’une installation du package de Joël sur sa machine.

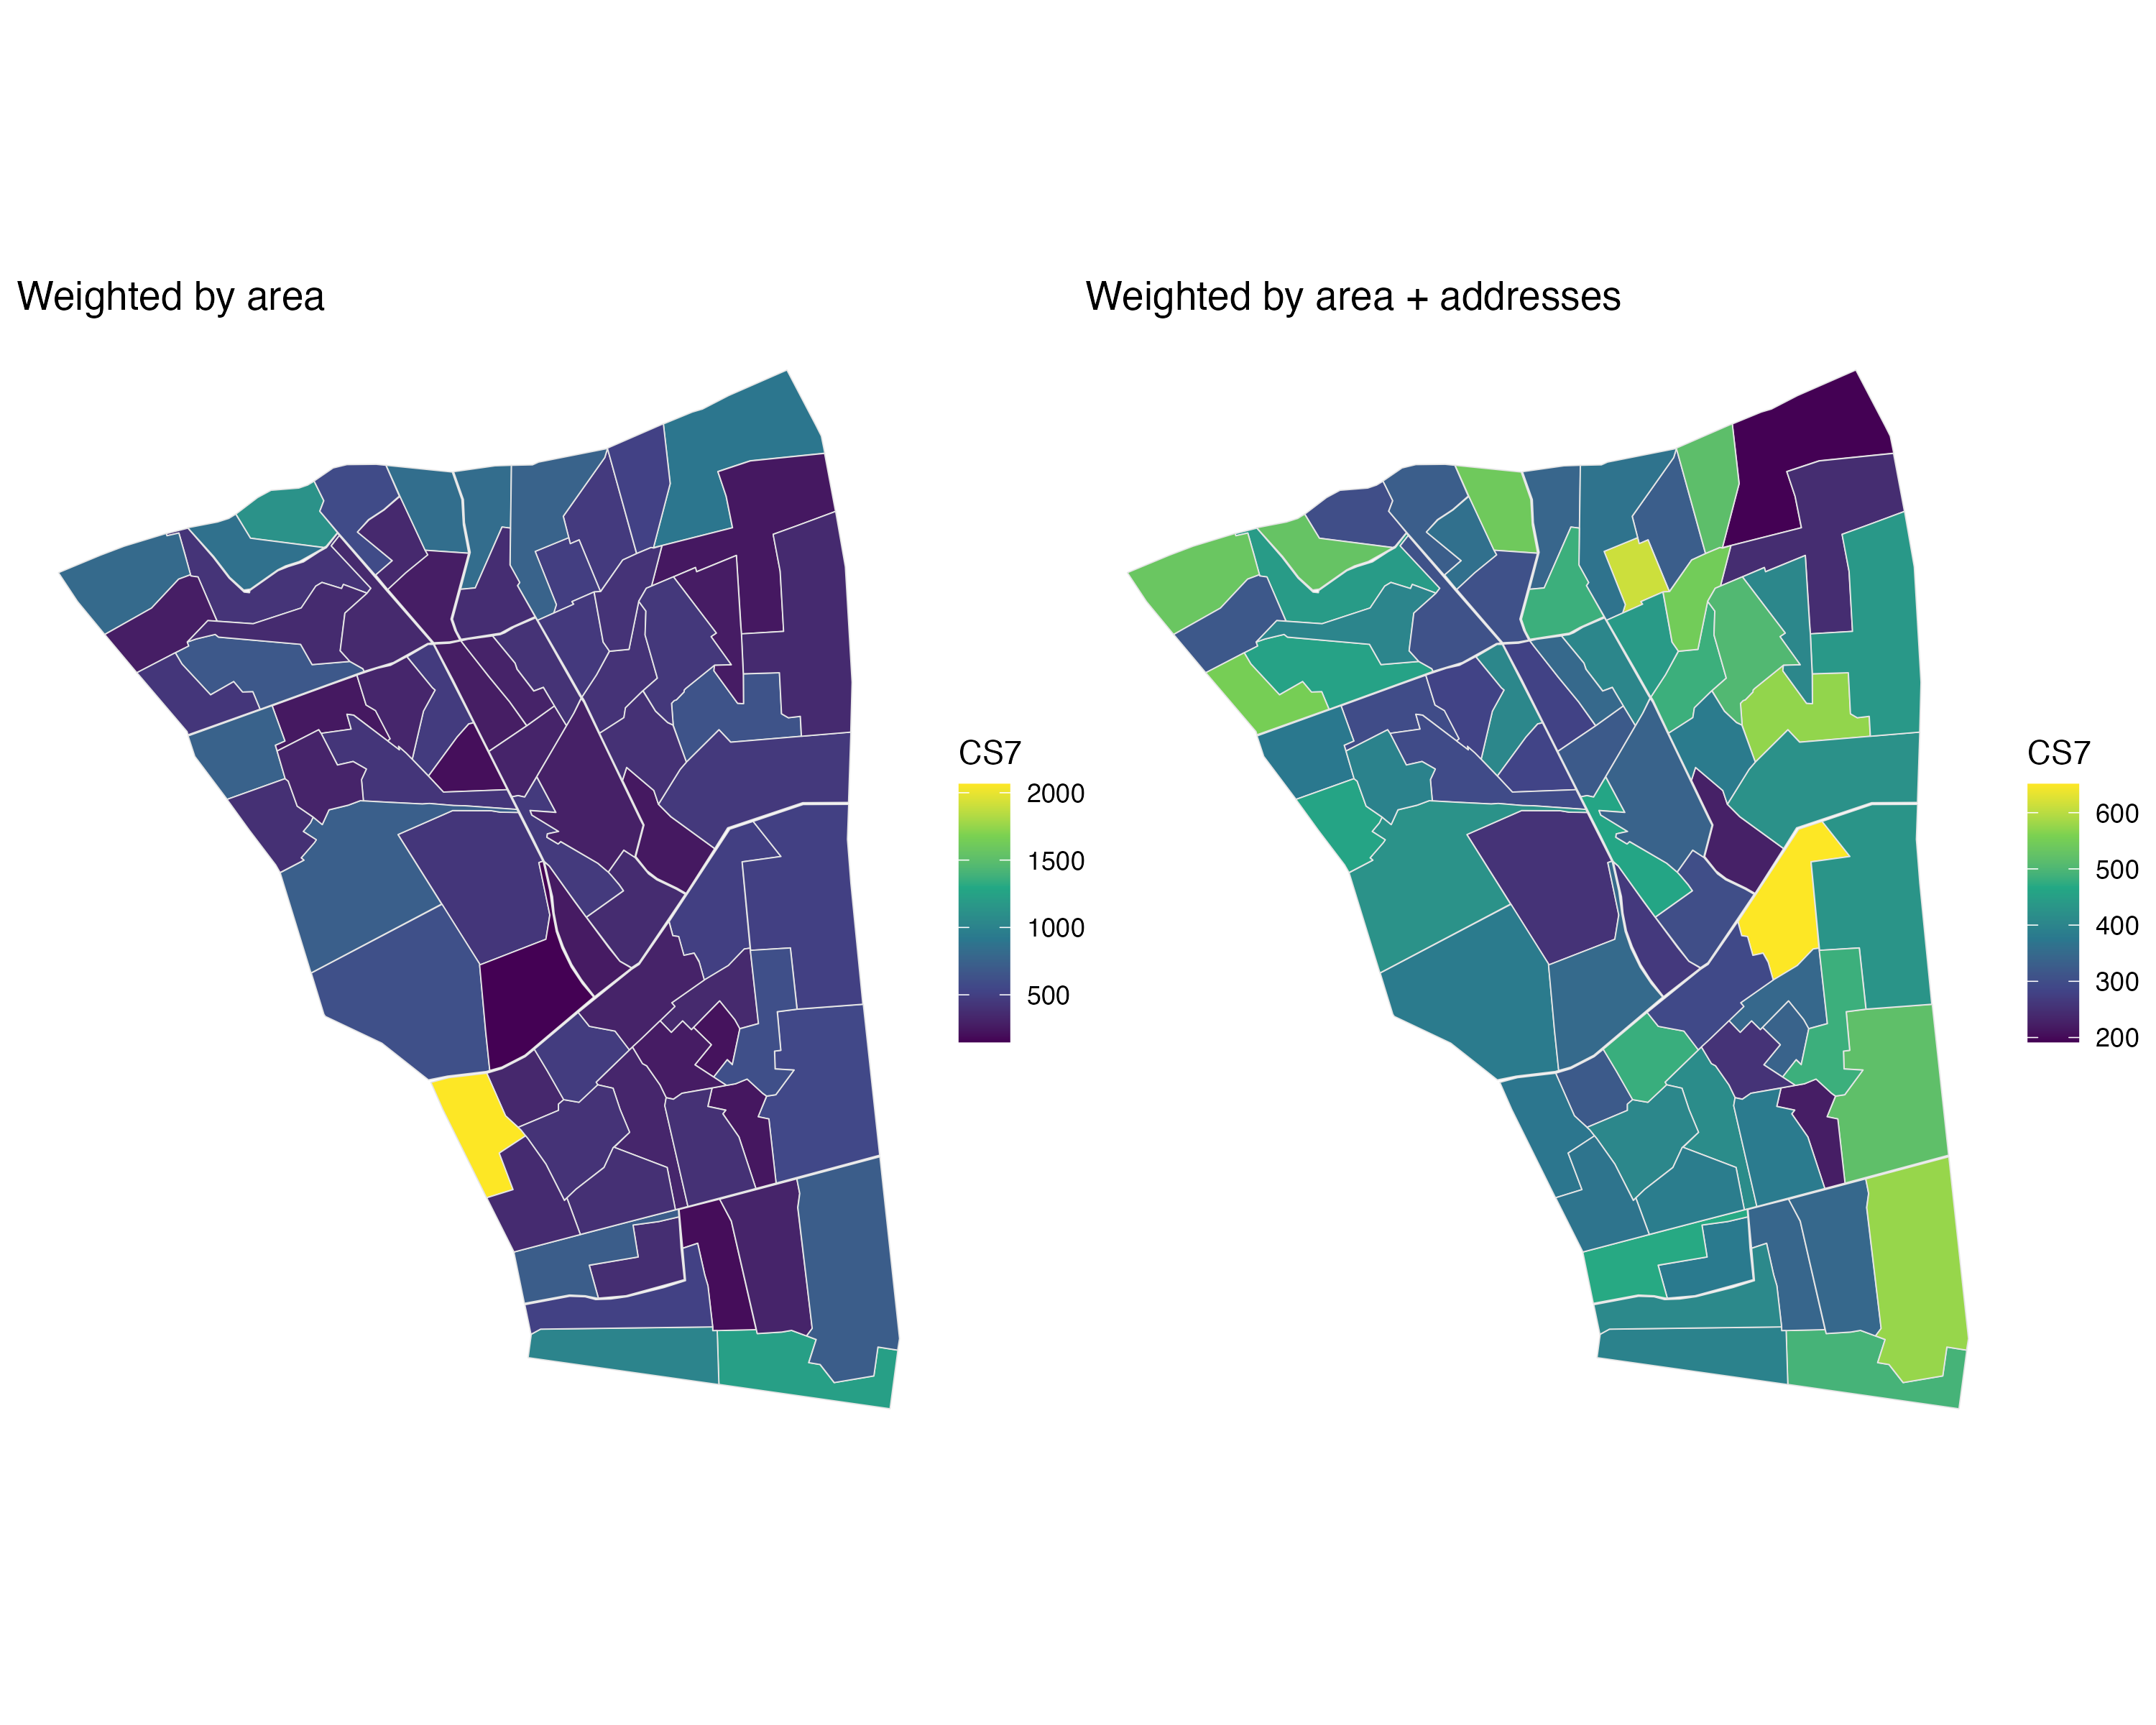
Comme je le remarquais dans ma note, quand on compare les résultats d’une interpolation pondérée à ceux d’une interpolation non pondérée (sous hypothèse d’équi-répartition), l’écart peut être assez saisissant. Cela s’observe nettement dans mon exemple ci-dessous, pour lequel le taux de corrélation entre les deux séries de résultats est très faible3 :Je n’ai pas plus d’observations à fournir à ce stade, si ce n’est qu’il me semble que ce type d’opération devrait a priori pouvoir servir à obtenir des résultats plus fins en sociologie électorale, un peu du type de ceux publiés dans cette Nouvelle cartographie électorale de la France que j’ai achetée sans avoir encore eu l’occasion de la lire4.

  1. J’utilise le 20e arrondissement de Paris comme exemple. Les IRIS sont contournés en bleu et les BV en rouge. Le code pour reproduire l’exemple est disponible en ligne, et les données sont disponibles dans le package sfReapportion, qui utilise les mêmes données d’illustration que le package initial de Joël. []
  2. Chaque point sur la carte correspond à une ou plusieurs adresse(s) d’électeurs, sans que l’on sache précisément combien d’électeurs résident à chaque adresse. Les données proviennent du Répertoire électoral unique (REU). Le grand espace vide à l’est est le cimetière du Père Lachaise. []
  3. On est toujours dans le 20e arrondissement, et la variable observée est le nombre de retraités (CS7). Le taux de corrélation est de 0.26. Pour les autres catégories socio-professionnelles, le taux varie de 0.30 (faible) à 0.75 (assez bon). Voir la fin du README du package pour le code et le détail. []
  4. J’ai quand même pris le temps de survoler l’annexe, qui détaille la méthodologie et son usage, notamment, du REU, et l’introduction, qui cite cet article de Joël sur l’ouverture des données électorales et le changement d’échelle à envisager à cette occasion. []

Quantitative Social Science Data

Il y a des siècles de ça, peu après avoir cherché (et, pour certaines, trouvé) les enquêtes électorales en France, je m’étais penché plus largement sur la disponibilité des enquêtes en sciences sociales — la disponibilité des données en sciences sociales faisant partie de mes obsessions de long terme, au moins depuis ma rencontre avec les mouvements free software/open source, puis Creative Commons, open access et open data1.

L’un des produits de mes recherches de l’époque est une page Web intitulée « Quantitative Social Science Data », dont j’avais fait une brève publicité en décembre 2018, et dont je me suis beaucoup servi depuis, notamment pour élaborer du contenu de cours.

Venant de m’en servir à nouveau dans le cadre d’une recherche collective avec quelques collègues de longue date, j’ai mis quelques liens à jour, et rajouté plusieurs enquêtes (longitudinales allemandes notamment). Je n’ai pas refait tourner mon code de vérification des URLs, dont plusieurs sont très certainement périmés d’une façon ou d’une autre, la liste initiale datant d’il y a plus de sept ans2.

Note d’entretien : ce billet est le troisième à sortir en trois mois. On est loin du rythme de publication initial de ce blog, mais l’on s’éloigne aussi de la longue période de mutisme débutée lors de l’épidémie de Covid-19. Je ne sais pas du tout si je vais conserver ce rythme, d’autant que je ne fais la promotion des billets sur aucun réseau social.

  1. L’hébergement de ce blog sur une plateforme liée au « Centre pour l’édition électronique ouverte » n’est évidemment pas une coïncidence. La démarche initiale du blog renvoie aux mêmes objectifs de diffusion libre des contenus, au-delà même de l’aspect « conversationnel » du blogging, qui n’existe d’ailleurs presque plus. []
  2. Le même problème se pose pour l’autre liste de liens que je gère, depuis presque dix ans, sur l’analyse de réseaux sociaux. []