


À défaut d’avoir écrit beaucoup de code cette année, j’en ai réécrit un peu.
Si vous suivez mon autre blog, consacré à R, vous avez déjà vu le résultat sur lequel j’ai passé le plus de temps : une réécriture du package R de Joël, spReapportion, package d’interpolation aréale qui était devenu très difficile à installer suite à la suppression de ses dépendances, en faveur du package sf plus récent.
Comme je l’explique dans une note publiée en fin d’année dernière, le package sert à interpoler des données découpées selon un contour géographique – typiquement, les IRIS de l’Insee – avec un autre contour : typiquement, ceux des bureaux de vote, établis par les municipalités. Vous pouvez voir la différence entre les deux maillages géographiques sur la carte de gauche ci-dessous1 :
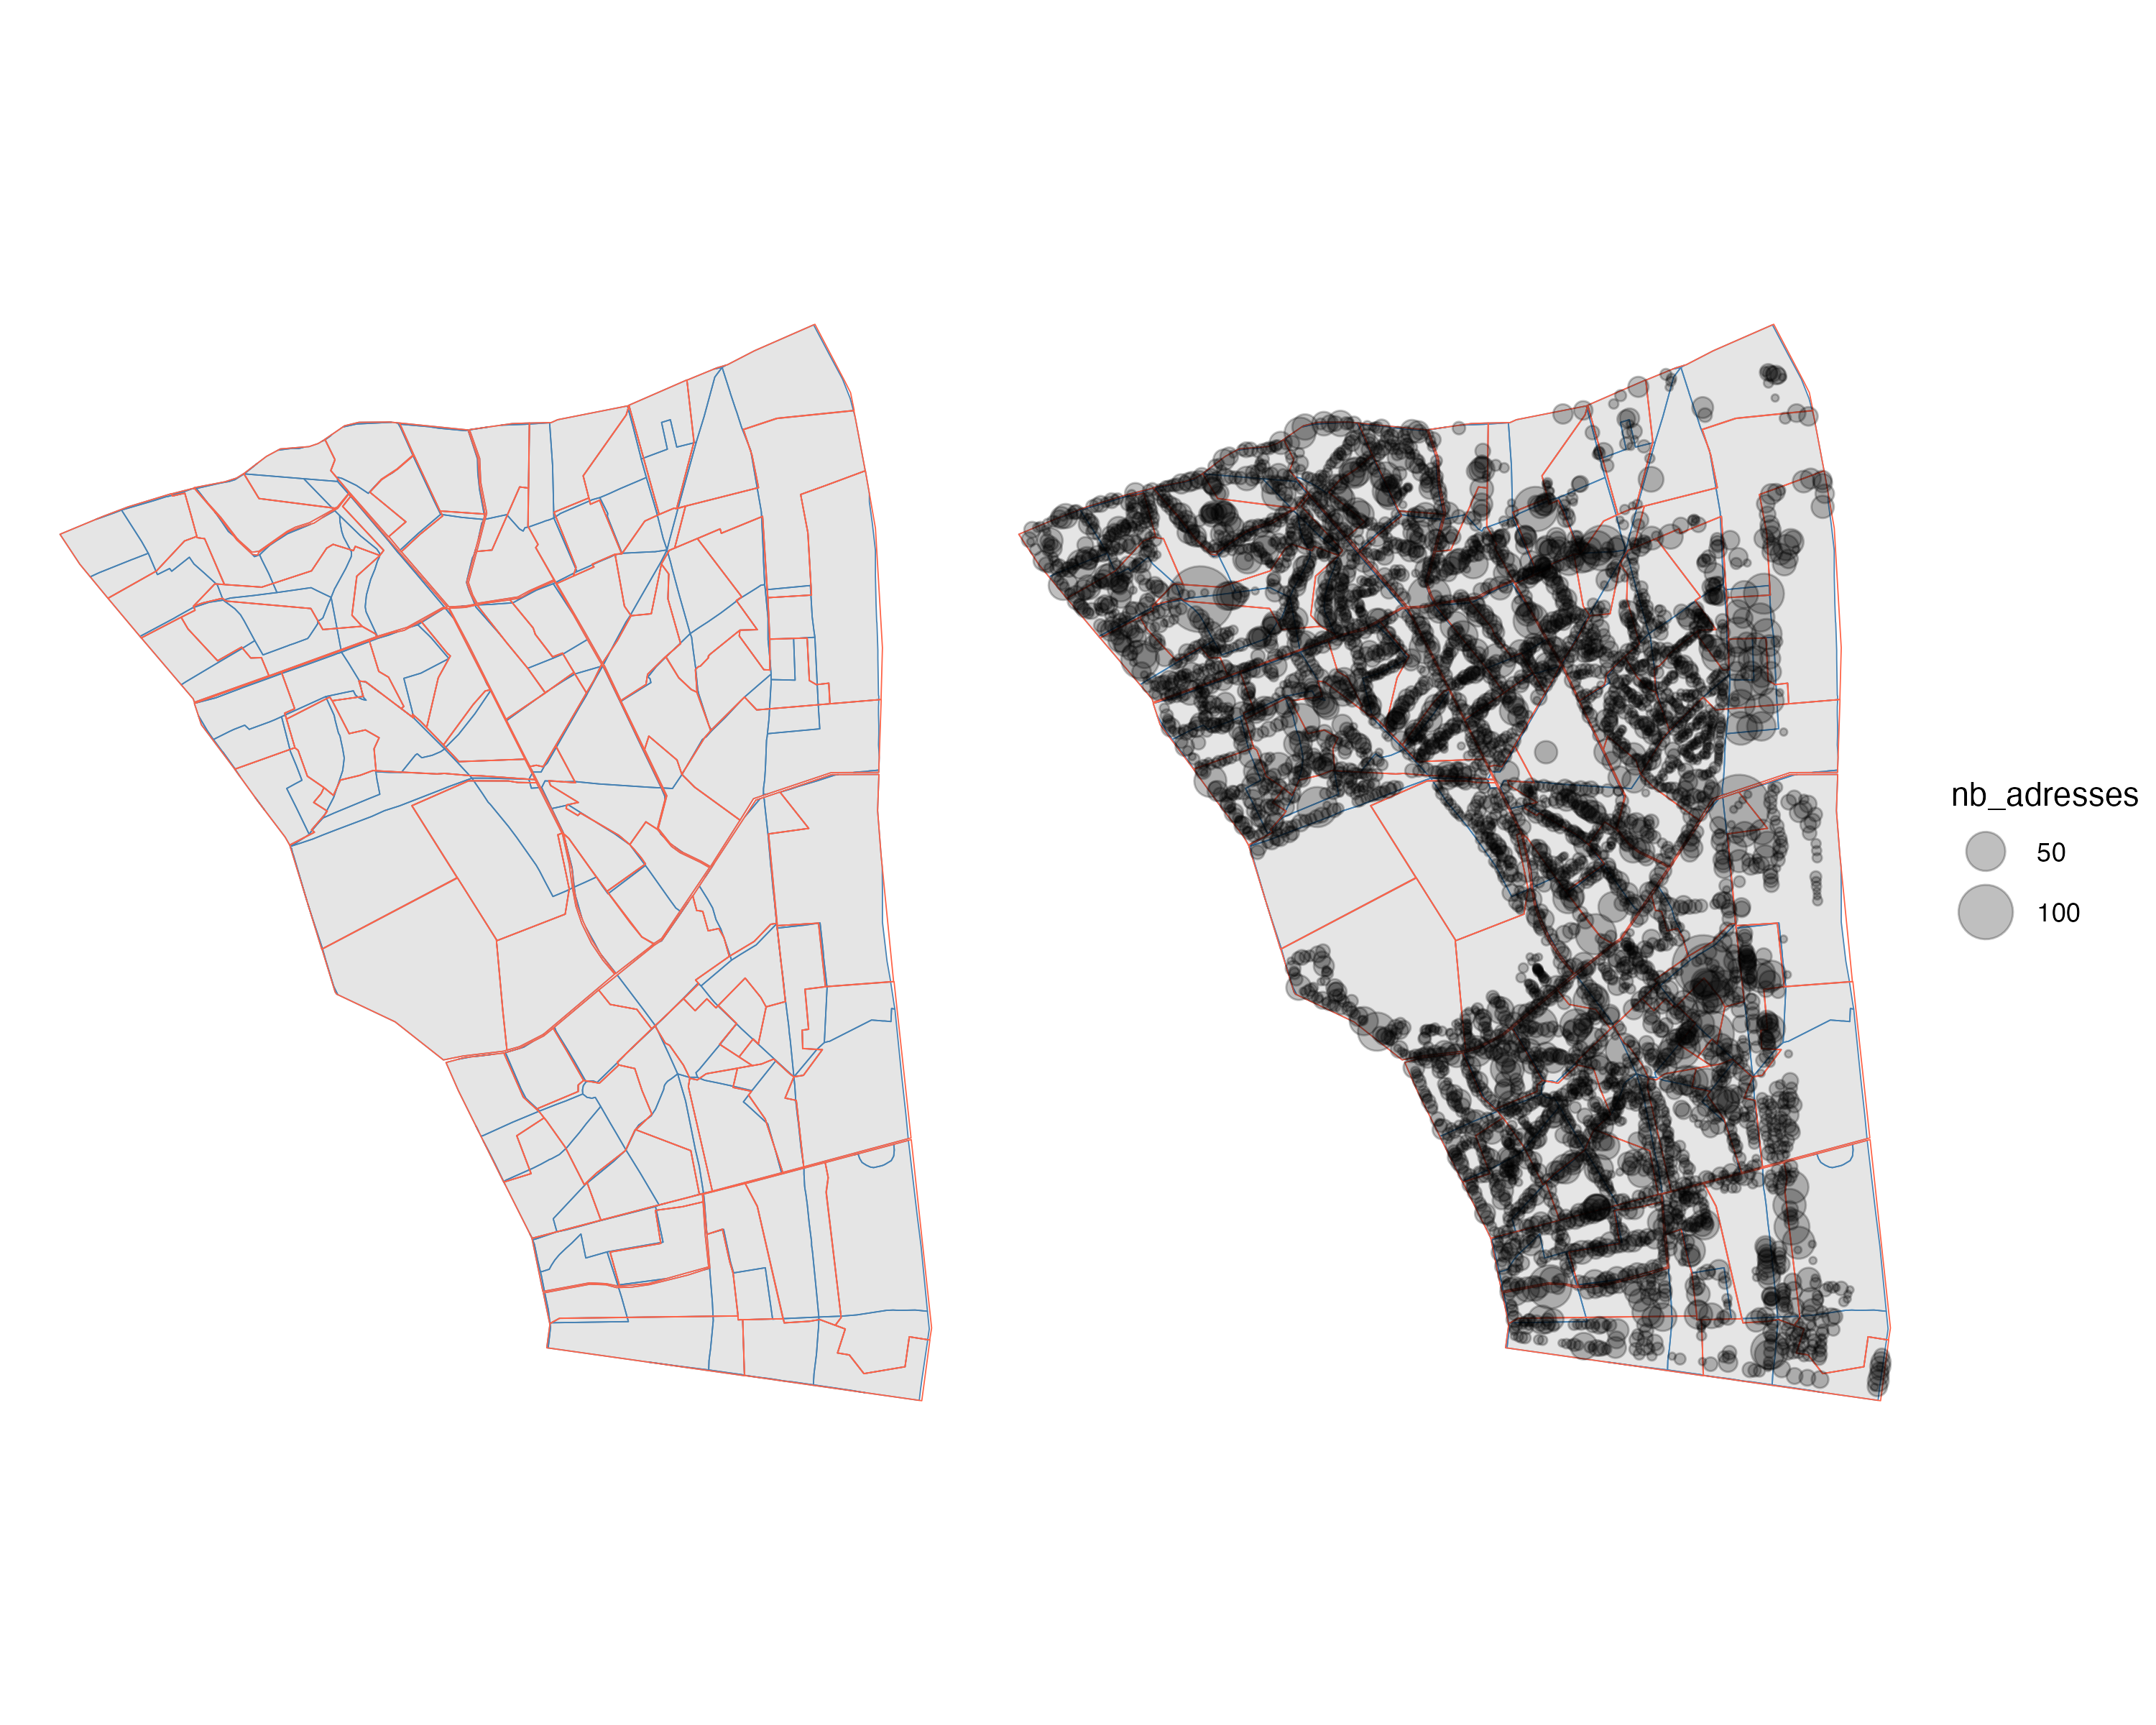
Il reste un problème à résoudre : comme le montre la carte de droite, les habitants / électeurs ne sont pas uniformément répartis à l’intérieur de chaque IRIS / BV2. En conséquence, quand on interpole les données, on peut vouloir pondérer le résultat de l’interpolation par cette répartition spatiale très inégale.
Joël avait écrit le code nécessaire pour effectuer cette pondération, mais sans fournir d’exemple. Après quelques bricolages, j’ai abouti à l’exemple fourni plus haut, puis réécrit son code, puis publié le tout, mais sans avoir pu vérifier que son package et ma version réécrite donnaient bien les mêmes résultats. C’est désormais chose faite depuis deux semaines, grâce à un collègue (merci Tristan) disposant encore d’une installation du package de Joël sur sa machine.
Comme je le remarquais dans ma note, quand on compare les résultats d’une interpolation pondérée à ceux d’une interpolation non pondérée (sous hypothèse d’équi-répartition), l’écart peut être assez saisissant. Cela s’observe nettement dans mon exemple ci-dessous, pour lequel le taux de corrélation entre les deux séries de résultats est très faible3 :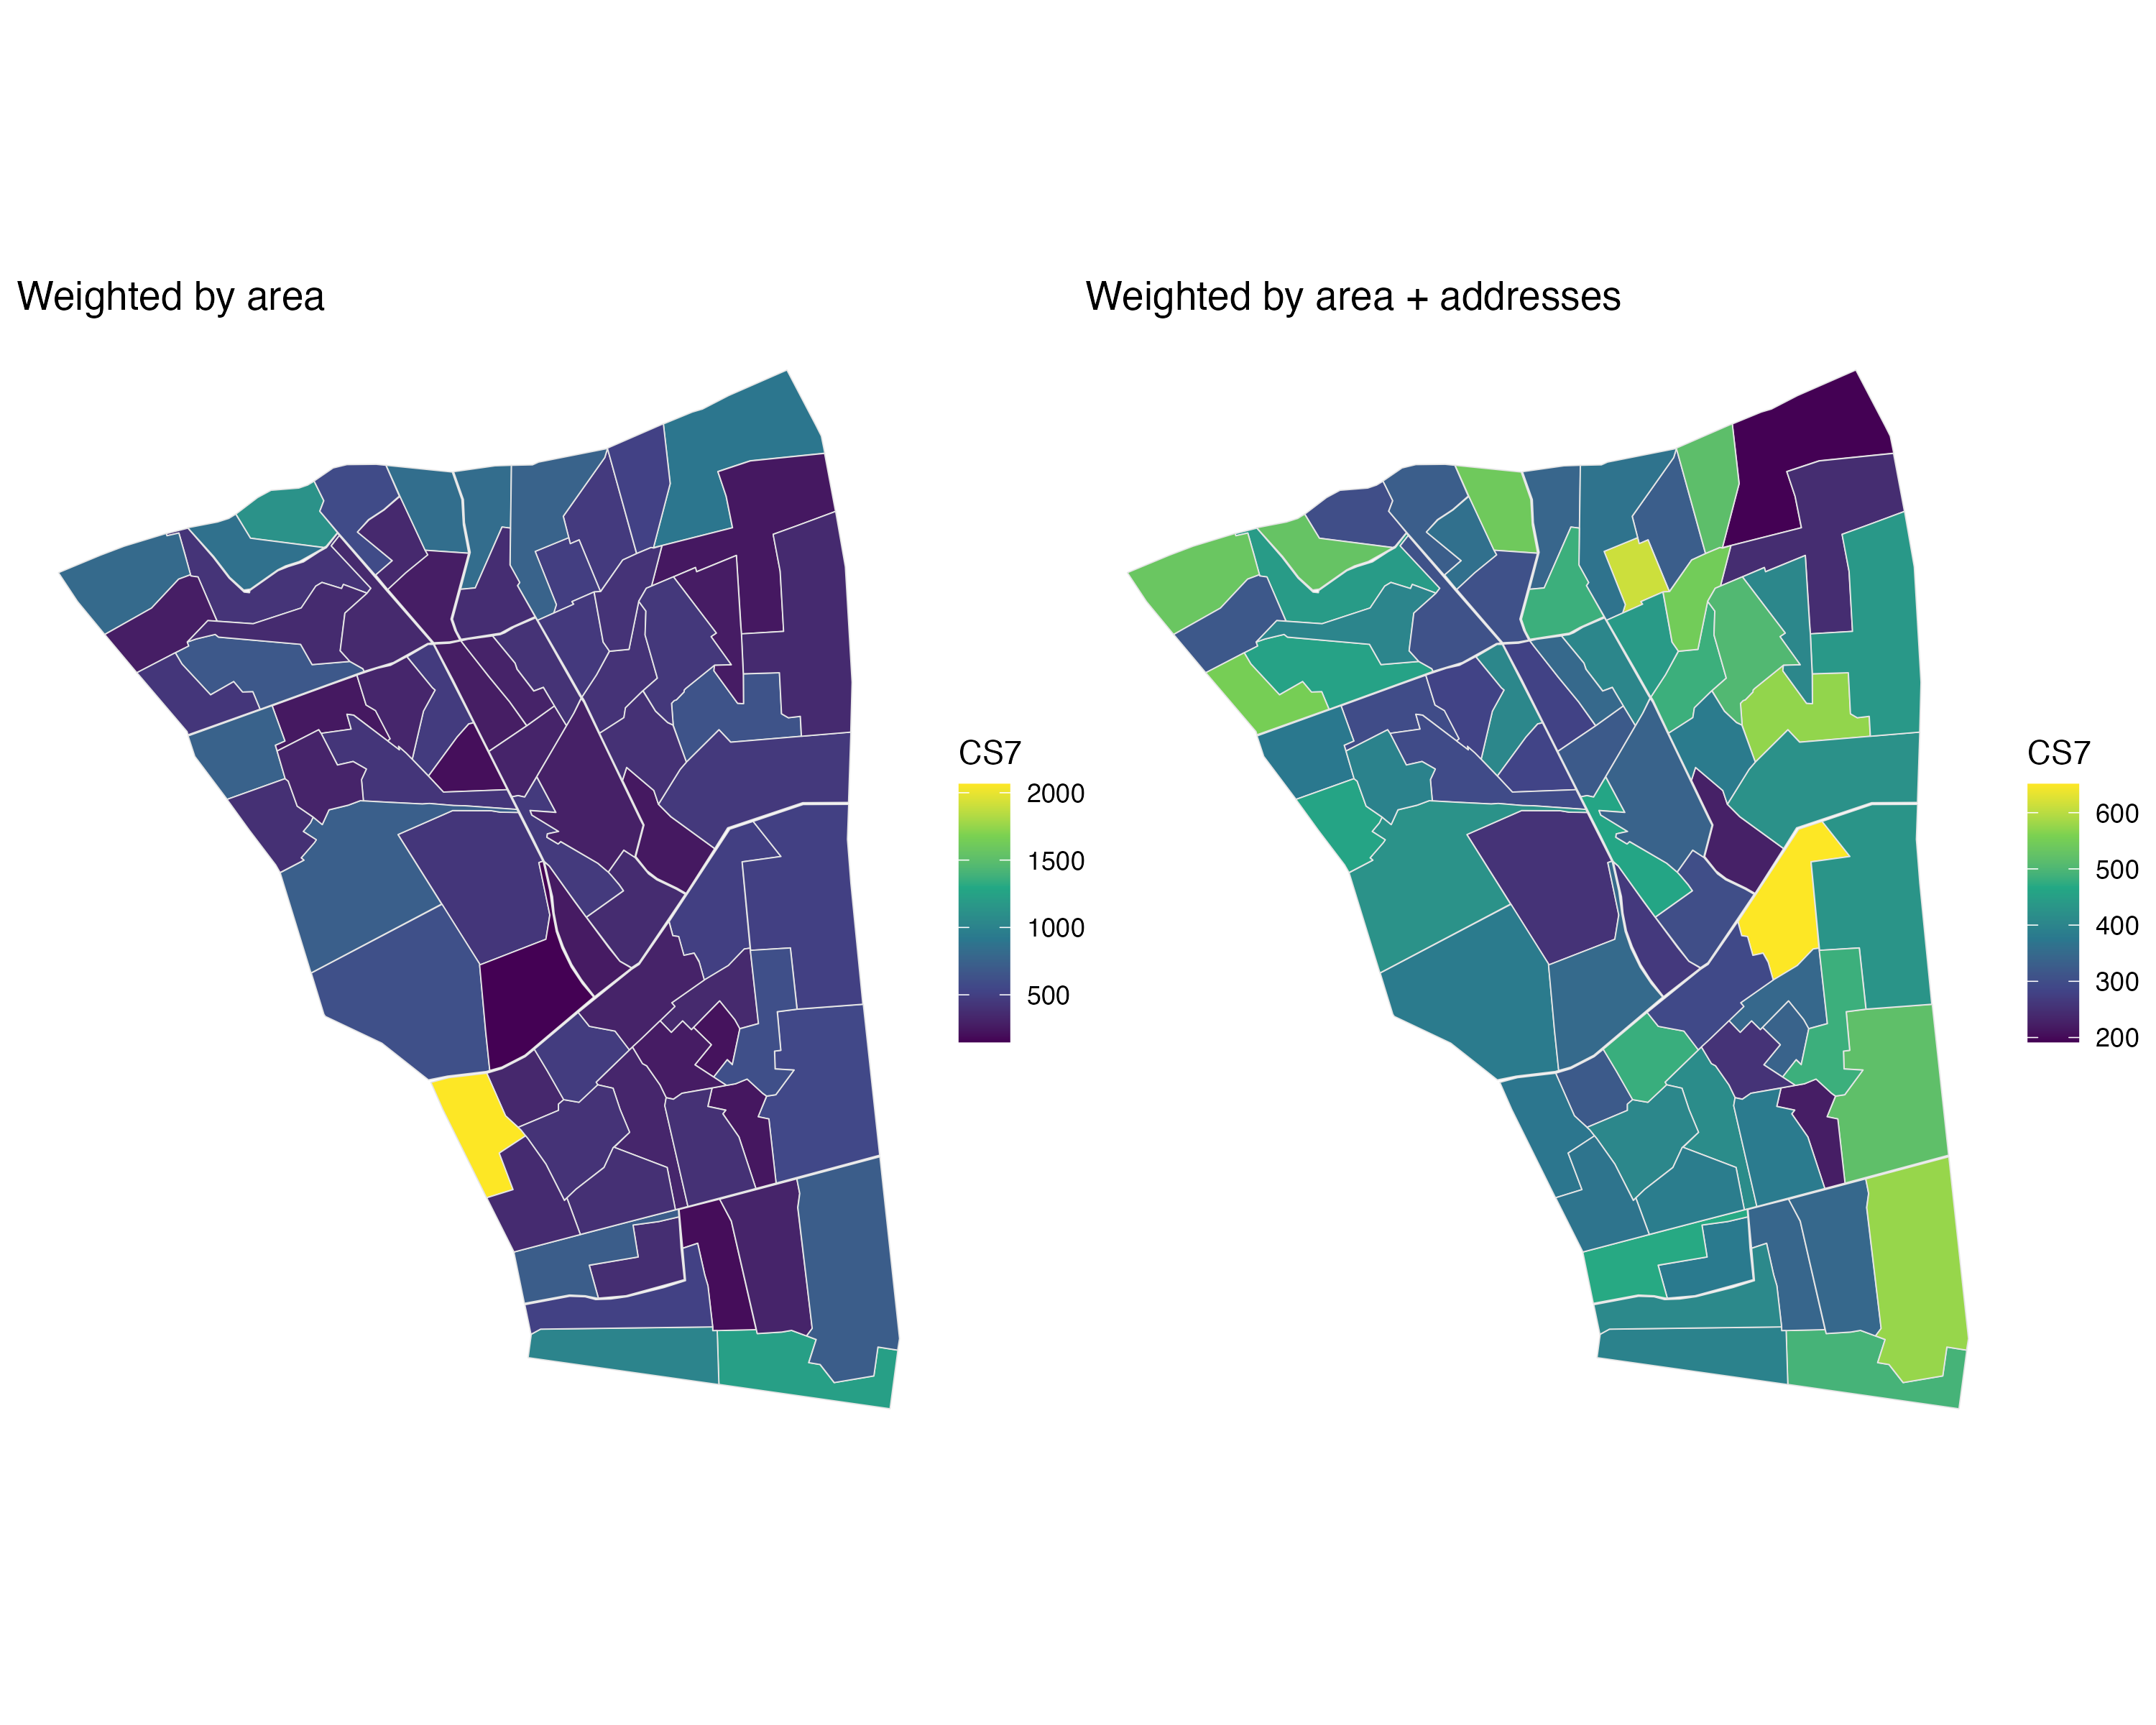 Je n’ai pas plus d’observations à fournir à ce stade, si ce n’est qu’il me semble que ce type d’opération devrait a priori pouvoir servir à obtenir des résultats plus fins en sociologie électorale, un peu du type de ceux publiés dans cette Nouvelle cartographie électorale de la France que j’ai achetée sans avoir encore eu l’occasion de la lire4.
- J’utilise le 20e arrondissement de Paris comme exemple. Les IRIS sont contournés en bleu et les BV en rouge. Le code pour reproduire l’exemple est disponible en ligne, et les données sont disponibles dans le package
sfReapportion, qui utilise les mêmes données d’illustration que le package initial de Joël. [↩] - Chaque point sur la carte correspond à une ou plusieurs adresse(s) d’électeurs, sans que l’on sache précisément combien d’électeurs résident à chaque adresse. Les données proviennent du Répertoire électoral unique (REU). Le grand espace vide à l’est est le cimetière du Père Lachaise. [↩]
- On est toujours dans le 20e arrondissement, et la variable observée est le nombre de retraités (CS7). Le taux de corrélation est de 0.26. Pour les autres catégories socio-professionnelles, le taux varie de 0.30 (faible) à 0.75 (assez bon). Voir la fin du README du package pour le code et le détail. [↩]
- J’ai quand même pris le temps de survoler l’annexe, qui détaille la méthodologie et son usage, notamment, du REU, et l’introduction, qui cite cet article de Joël sur l’ouverture des données électorales et le changement d’échelle à envisager à cette occasion. [↩]

OpenEdition vous propose de citer ce billet de la manière suivante :
François (15 juin 2026). Un problème d’interpolation spatiale. Polit’bistro. Consulté le 6 octobre 2026 à l’adresse https://doi.org/10.58079/16e99